Dalam final project Bootcamp Data Engineer With Python, peserta mengembangkan pipeline untuk mengolah dataset Brazilian E-Commerce Olist. Proyek ini mencakup pemuatan data CSV ke ClickHouse, transformasi menggunakan dbt, orkestrasi melalui Apache Airflow, dan validasi tabel hasil.
Sebagai penyelenggara, kami melihat proyek ini sebagai praktik menghubungkan tahapan data engineering dalam satu alur. Peserta menyusun proses yang memiliki dependensi jelas, mulai dari pemeriksaan koneksi database hingga pemeriksaan hasil transformasi.
Studi Kasus: Menghubungkan Data Operasional E-Commerce
Dataset Olist mencakup pelanggan, lokasi geografis, produk, kategori produk, penjual, pesanan, item pesanan, pembayaran, dan ulasan. Informasi tersebut tersedia dalam sembilan file CSV yang perlu diorganisasi sebelum digunakan untuk analisis.
Proyek ini mengangkat kebutuhan untuk menghubungkan data pesanan dengan informasi pendukungnya. Satu pesanan dapat memiliki beberapa item, pembayaran, dan ulasan, sehingga penggabungan data membutuhkan perhatian terhadap tingkat detail setiap tabel.
Hasil yang dituju adalah model analitis yang memudahkan penelusuran nilai pesanan, ongkos kirim, pembayaran, serta skor ulasan tanpa harus selalu mengolah ulang file sumber.
Apa yang Dikerjakan Peserta?
Peserta menyusun pipeline dengan tahapan berikut:
- Memeriksa koneksi ClickHouse sebelum pemrosesan dimulai.
- Membaca dan memuat file CSV menggunakan Python.
- Membentuk lapisan silver melalui transformasi dbt.
- Menyusun lapisan gold untuk kebutuhan analitis.
- Memvalidasi bahwa tabel utama memiliki data.
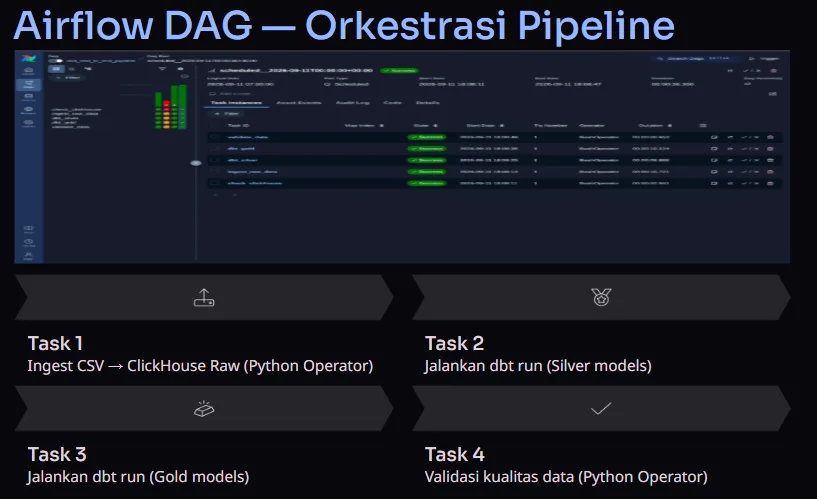
- Mengatur seluruh tahapan dalam DAG Airflow dengan jadwal harian.
Struktur proyek memisahkan skrip ingestion, model dbt, konfigurasi Airflow, dan skrip validasi. Pemisahan ini membantu peserta menelusuri tanggung jawab setiap komponen ketika terjadi kesalahan.
Teknologi dan Tools yang Digunakan
Python digunakan untuk ingestion dan validasi. Pandas menangani pembacaan serta pengolahan data CSV, sedangkan SQLAlchemy digunakan untuk berinteraksi dengan database.
ClickHouse menjadi database analitis yang menampung data mentah dan hasil transformasi. dbt Core bersama adapter dbt-clickhouse digunakan untuk mendefinisikan model SQL serta hubungan antarmodel.
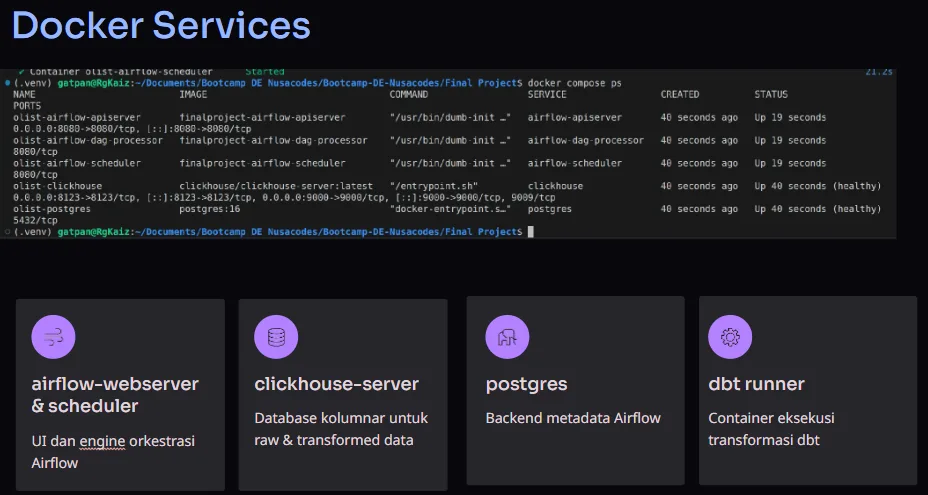
Apache Airflow mengatur urutan eksekusi dan penjadwalan pipeline. Docker dan Docker Compose menyediakan konfigurasi layanan, termasuk ClickHouse, komponen Airflow, dan PostgreSQL sebagai database metadata Airflow.
Penggunaan teknologi tersebut memperkenalkan peserta pada pemisahan fungsi antara penyimpanan data, transformasi, orkestrasi, dan pengelolaan lingkungan eksekusi.
Pengolahan Data Melalui Lapisan Silver dan Gold
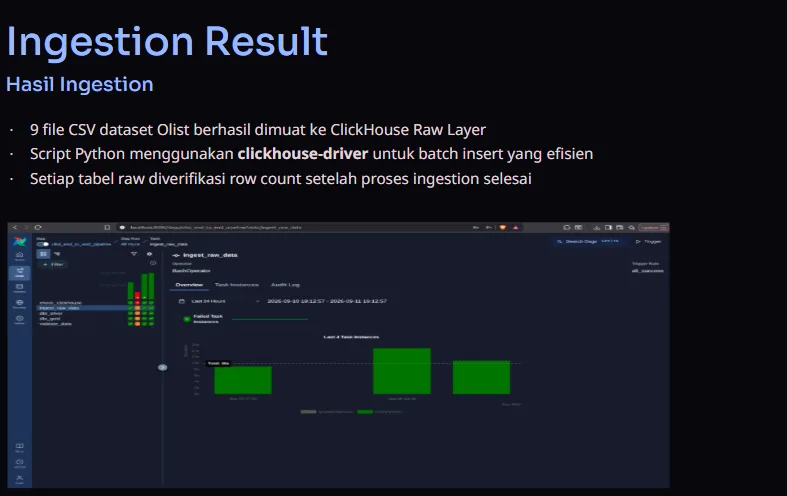
Pada tahap ingestion, skrip dirancang untuk membaca CSV, menormalisasi nama kolom, mendeteksi tipe data, menangani nilai kosong, serta membuat tabel ClickHouse.
Lapisan silver menyusun model pelanggan, produk, penjual, pesanan, item pesanan, pembayaran, dan ulasan. Salah satu pengolahannya adalah parsing kolom waktu pesanan dengan penanganan nilai kosong.
Lapisan gold menyediakan dimensi pelanggan, produk, dan penjual, serta tabel fakta pesanan. Model gold_fct_orders dirancang pada tingkat satu baris per pesanan.
Model tersebut menggabungkan informasi status pesanan dengan jumlah item, nilai produk, ongkos kirim, total pembayaran, metode pembayaran, dan rata-rata skor ulasan. Pesanan yang ditandai dibatalkan dikeluarkan dari hasil akhir model.
Orkestrasi Harian dengan Apache Airflow
DAG proyek disusun dengan urutan pemeriksaan koneksi, ingestion, transformasi silver, transformasi gold, dan validasi. Setiap tahap bergantung pada keberhasilan tahap sebelumnya.
Pemeriksaan awal menggunakan endpoint kesehatan ClickHouse untuk memastikan layanan merespons. Setelah itu, Airflow menjalankan skrip Python dan perintah dbt melalui task yang terpisah.
Jadwal menggunakan konfigurasi harian dengan catchup=False. Dengan pengaturan ini, DAG tidak otomatis menjalankan seluruh jadwal historis yang terlewat.
Bagi peserta, alur tersebut menjadi latihan memahami bahwa keberhasilan transformasi bergantung pada kesiapan sumber, koneksi, dan hasil proses sebelumnya.
Hasil dan Batas Validasi
README proyek mencantumkan contoh hasil validasi sebanyak 99.441 baris pada tabel pelanggan dan pesanan, serta 98.207 baris pada tabel fakta pesanan gold.
Skrip validasi yang tersedia menghitung jumlah baris pada enam tabel utama di lapisan mentah, silver, dan gold. Jika sebuah tabel kosong, skrip menghasilkan kesalahan agar tahap tersebut tidak dinyatakan berhasil.
Pemeriksaan ini berguna untuk mendeteksi keluaran kosong. Namun, cakupannya belum memastikan keunikan ID, kelengkapan relasi, atau ketepatan seluruh perhitungan. Jumlah baris yang terisi menjadi pemeriksaan awal, sedangkan kualitas isi membutuhkan pengujian tambahan.
Insight: Tingkat Detail Data Memengaruhi Hasil Analisis
Salah satu pembelajaran penting adalah menentukan tingkat detail sebelum menggabungkan tabel. Pada model gold, pembayaran dan ulasan diringkas per pesanan sebelum digabungkan dengan data lainnya. Pendekatan ini membantu mengurangi risiko penggandaan nilai akibat hubungan satu-ke-banyak.
Model yang terbentuk menyediakan dasar untuk menelaah komposisi nilai pesanan, kontribusi ongkos kirim, variasi metode pembayaran, dan skor ulasan. Berkas yang tersedia menunjukkan penyusunan metrik tersebut, belum berupa kesimpulan bisnis tentang kategori terlaris atau penyebab kepuasan pelanggan.
Penyaringan pesanan dibatalkan juga memperlihatkan bahwa aturan transformasi menentukan populasi data yang dianalisis. Pengguna hasil perlu mengetahui batas tersebut saat membaca ringkasan.
Manfaat Pembelajaran
Melalui proyek ini, peserta memperoleh pengalaman mengolah beberapa sumber CSV, membangun model SQL berlapis, mengatur dependensi task, dan memeriksa keluaran pipeline.
Bagi kami sebagai penyelenggara Bootcamp Data Engineer With Python, proyek ini menyediakan fondasi praktik untuk menyiapkan data analitis secara terstruktur. Pengembangan berikutnya dapat difokuskan pada pengujian keunikan pesanan, konsistensi relasi, dan rekonsiliasi nilai pembayaran agar validasi mencakup isi data secara lebih mendalam.