Dalam final project Bootcamp Python Programming Fundamental, peserta mengangkat studi kasus analisis harga harian pasangan mata uang USD/JPY. Proyek ini menggabungkan pengolahan file, pembersihan data, penyimpanan database, visualisasi, dan eksperimen model prediksi dalam sebuah program Python.
Sebagai penyelenggara, kami melihat proyek ini sebagai penerapan materi pemrograman pada alur analisis yang saling terhubung. Peserta menyusun fungsi untuk mengubah data mentah menjadi informasi yang dapat dibaca, divisualisasikan, dan digunakan dalam eksperimen pemodelan.
Studi Kasus: Membaca Pergerakan Harga Harian
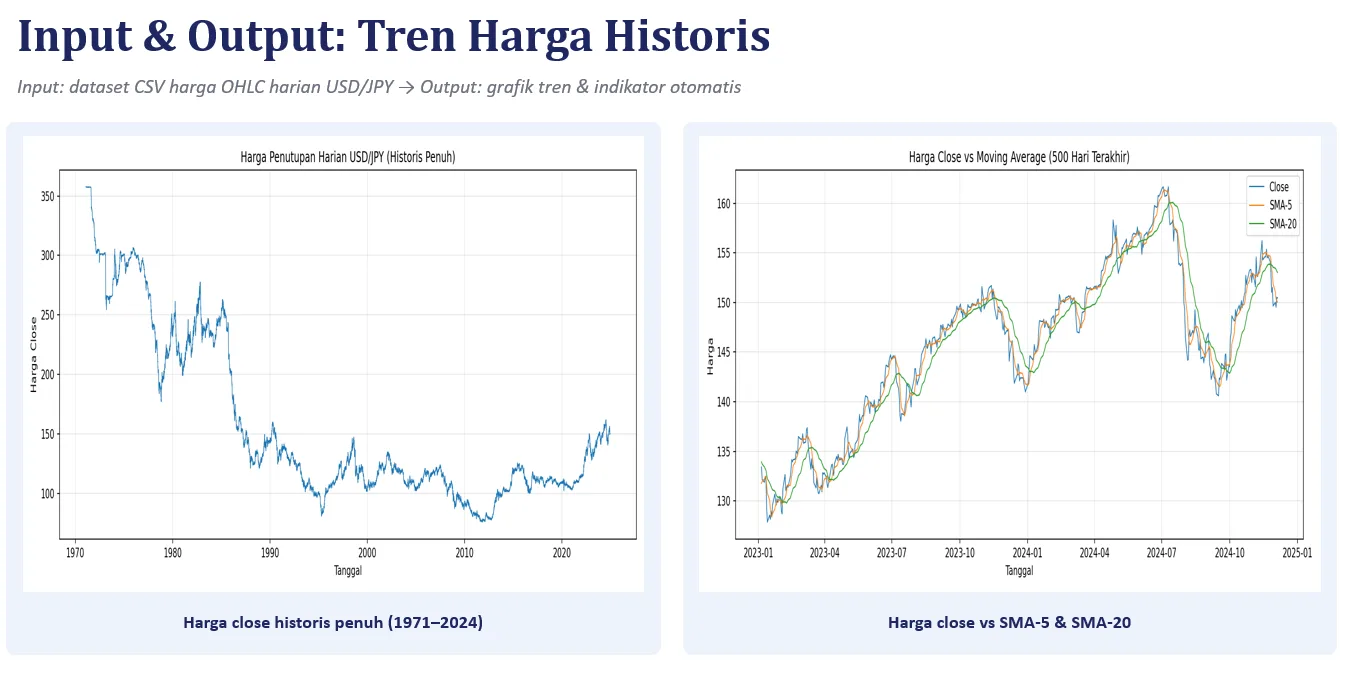
Berdasarkan dokumentasi proyek, dataset mencakup harga harian USD/JPY pada periode 1971–2024 dengan sekitar 13.900 baris. Data memuat tanggal, harga pembukaan, harga tertinggi, harga terendah, harga penutupan, dan tick volume.
Pertanyaan yang diangkat adalah bagaimana menggambarkan perubahan harga dari waktu ke waktu serta membandingkan beberapa pendekatan untuk memodelkan harga penutupan.
Untuk eksperimen machine learning, program menggunakan 2.000 observasi harian terakhir. Pembatasan ini membuat proses pelatihan berfokus pada bagian data terbaru sekaligus mengurangi kebutuhan komputasi.
Apa yang Dikerjakan Peserta?
Peserta membagi proyek menjadi modul pengolahan data, visualisasi, prediksi, dan program utama. Setiap tahap menggunakan fungsi terpisah agar alurnya lebih mudah ditelusuri.
Pekerjaan yang tercakup meliputi:
- Membaca dataset CSV dan mengubah kolom tanggal ke format yang sesuai.
- Mengonversi kolom harga menjadi numerik serta menangani nilai kosong atau tidak valid.
- Mengurutkan data berdasarkan tanggal dan menghapus duplikasi tanggal.
- Menghitung return harian, moving average, volatilitas bergulir, dan harga periode sebelumnya.
- Menyimpan serta membaca kembali data melalui SQLite.
- Menyusun statistik deskriptif dan grafik eksplorasi.
- Melatih empat model serta membandingkan metrik evaluasinya.
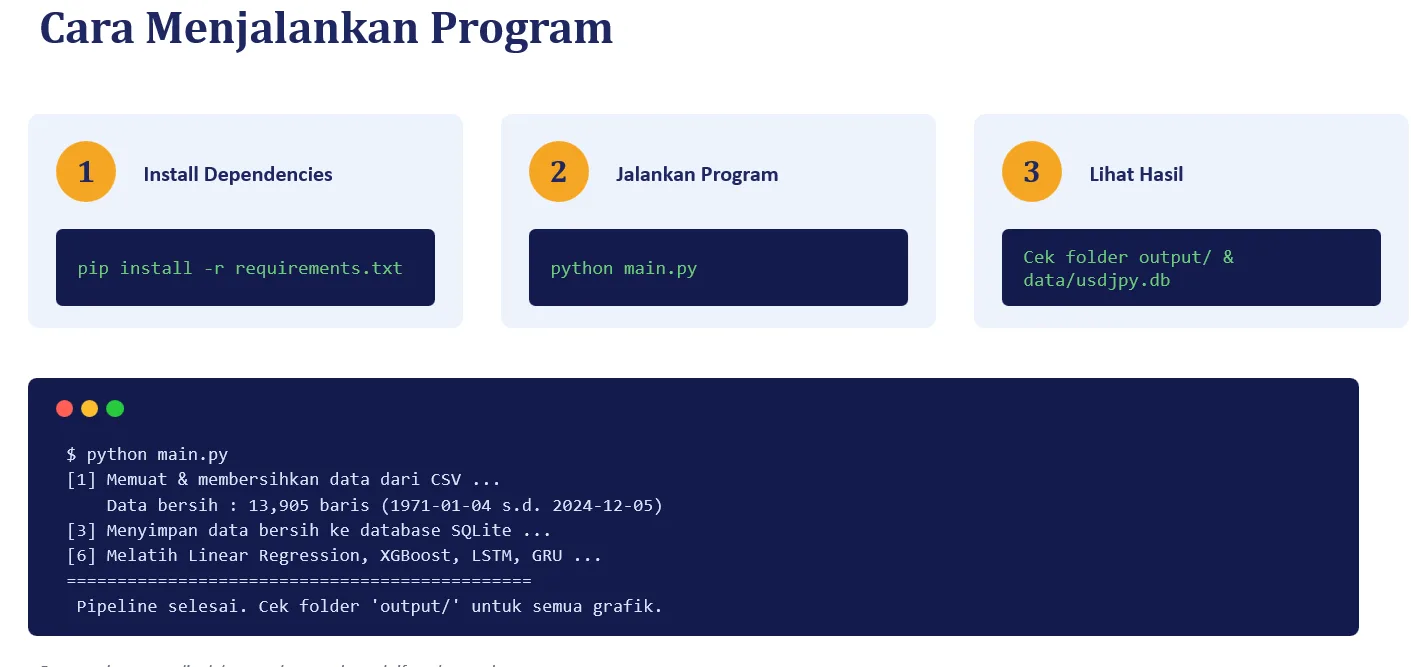
Program juga menyediakan menu terminal interaktif. Pengguna dapat memilih tahapan tertentu atau menjalankan seluruh alur sekaligus. Fitur ini menjadi latihan penggunaan percabangan, perulangan, fungsi, dan pengelolaan input pengguna.
Teknologi dan Tools yang Digunakan
Python menjadi bahasa utama untuk menyusun proses analisis. Pandas digunakan untuk mengelola tabel, membersihkan data, dan membuat fitur turunan. NumPy mendukung perhitungan numerik serta statistik.
SQLite, melalui modul sqlite3, digunakan untuk menyimpan hasil pengolahan. Peserta berlatih memindahkan data dari CSV ke database dan membacanya kembali untuk tahap berikutnya.
Matplotlib digunakan untuk membuat grafik harga historis, moving average, distribusi return, serta perbandingan prediksi dan error.
Untuk pemodelan, proyek menggunakan scikit-learn bagi Linear Regression, normalisasi, dan metrik evaluasi; TensorFlow/Keras untuk LSTM dan GRU; serta XGBoost untuk model berbasis kumpulan pohon keputusan.
Mengubah Harga Menjadi Informasi
Peserta menambahkan moving average lima dan dua puluh hari untuk membantu membaca pergerakan harga dalam rentang berbeda. Return harian digunakan untuk menggambarkan perubahan relatif, sedangkan standar deviasi return dalam jendela sepuluh hari menjadi ukuran volatilitas bergulir.
Fitur harga tertunda satu hingga lima hari juga dibuat sebagai masukan model tabular. Proses ini memperkenalkan hubungan antara urutan waktu dan informasi yang digunakan dalam prediksi.
Visualisasi yang disusun mencakup riwayat harga penuh, perbandingan harga dengan moving average pada 500 observasi terakhir, dan histogram return harian. Ketiganya menyediakan sudut pandang berbeda terhadap dataset: tren, perubahan jangka pendek, dan distribusi pergerakan harga.
Eksperimen Empat Model
Peserta membandingkan Linear Regression, XGBoost, LSTM, dan GRU. Linear Regression dan XGBoost menggunakan fitur tabular, sementara LSTM dan GRU menerima rangkaian dua puluh harga penutupan sebelumnya.
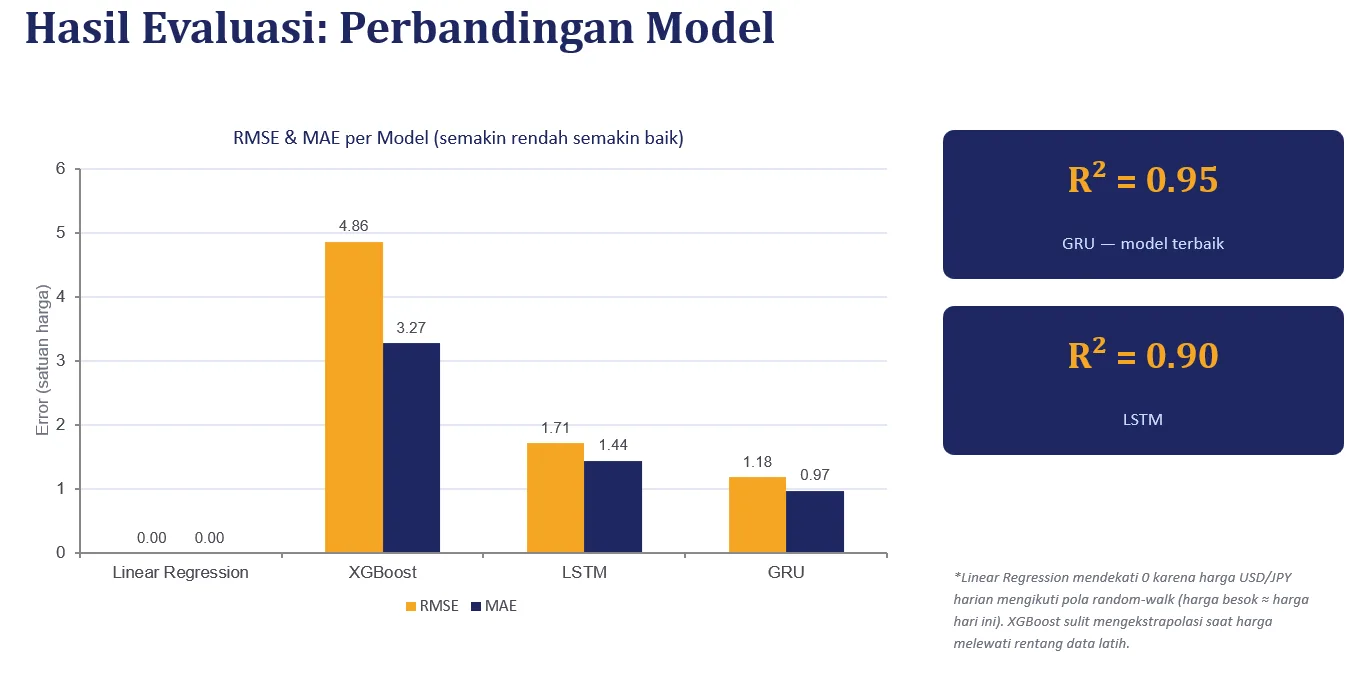
Data dibagi secara kronologis dengan proporsi sekitar 80% untuk pelatihan dan 20% untuk pengujian. Program menghitung RMSE, MAE, MAPE, dan R², lalu menyiapkan grafik perbandingan serta ekspor tabel metrik ke CSV.
Dokumentasi mencatat bahwa GRU menghasilkan error lebih rendah daripada LSTM pada eksperimen yang dilaporkan. Namun, hasil tersebut perlu dibaca bersama rancangan fitur dan proses prapemrosesannya sebelum digunakan untuk menyimpulkan kemampuan prediksi.
Insight: Evaluasi Membutuhkan Pemeriksaan Data
Salah satu pelajaran penting dari peninjauan proyek ini adalah bahwa error yang sangat kecil belum tentu menunjukkan kemampuan memprediksi masa depan.
Pada model tabular, target menggunakan harga penutupan pada baris yang sama, sedangkan moving average lima hari masih memasukkan harga tersebut. Bersama fitur harga tertunda, kombinasi ini memungkinkan model merekonstruksi target. Karena itu, hasil Linear Regression yang mendekati sempurna dalam dokumentasi perlu ditinjau sebagai indikasi kebocoran target.
Pada model LSTM dan GRU, normalisasi juga dihitung sebelum pembagian data. Perbaikannya adalah mempelajari parameter normalisasi hanya dari data latih, kemudian menerapkannya pada data uji.
Kedua temuan tersebut memberikan konteks konkret bahwa pembagian kronologis perlu disertai pemeriksaan fitur dan prapemrosesan agar evaluasi sesuai dengan tujuan prediksi.
Manfaat Pembelajaran dan Pengembangan Berikutnya
Proyek ini memberi peserta pengalaman menyusun alur analisis dari pembacaan file hingga pelaporan hasil. Penggunaan modul dan fungsi membantu memisahkan tanggung jawab kode, sementara database dan visualisasi memperluas praktik di luar perhitungan dasar.
Pengembangan berikutnya dapat difokuskan pada penyelarasan fitur dengan waktu prediksi, perbaikan normalisasi, dan penyamaan periode uji antarpendekatan. Lokasi dataset juga perlu disesuaikan karena program mengarah ke folder data, sedangkan file yang diserahkan berada di direktori utama.
Bagi kami sebagai penyelenggara, nilai pembelajaran proyek ini terletak pada penggabungan dasar Python dengan proses analisis yang dapat diperiksa. Peserta memiliki bahan konkret untuk memahami bahwa kualitas hasil bergantung pada pengolahan data dan ketepatan evaluasi, selain pemilihan model.